Magasin en mémoire compatible avec Redis avec recherche vectorielle native
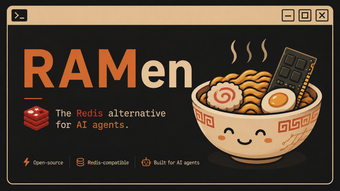
RAMen, par Rohit Dnath, est un magasin de données en mémoire conçu pour soutenir les flux de travail pilotés par l'IA et la mémoire des agents. L'outil accepte un accès de style clé-valeur tout en ajoutant une récupération sémantique afin que les applications puissent récupérer du contenu par signification au lieu de correspondances exactes. Il cible les développeurs d'IA et les ingénieurs backend qui ont besoin d'un magasin local pour réduire la latence et éviter les appels de modèle répétés, et s'intègre avec des écosystèmes d'agents qui utilisent un protocole pour l'échange de contexte de modèle.
Quelles tâches pouvez-vous réellement utiliser pour cela ?
L'outil fonctionne comme un magasin en mémoire qui fusionne l'accès de style Redis avec la récupération vectorielle et sémantique pour les charges de travail d'IA. Il accepte les commandes du protocole Redis, expose un cache sémantique pour des recherches basées sur le sens, et exécute un serveur de protocole de contexte de modèle que les agents peuvent interroger directement. L'implémentation principale est écrite en Go et optimisée pour les performances en mémoire, donc les cas d'utilisation incluent une récupération locale rapide pour la mémoire des agents, le contexte de session et les réponses LLM mises en cache.
Quelle est la précision de la récupération sémantique pour les flux de travail d'IA ?
Le cache sémantique stocke et récupère les réponses d'IA en fonction du sens plutôt que des correspondances exactes de mots-clés, un design destiné à réduire les appels LLM et à diminuer la latence lors de la récupération. La recherche vectorielle native gère des embeddings de haute dimension pour soutenir ces recherches. Les sorties reflètent la qualité de l'index et de l'embedding, donc les équipes devraient valider les réponses mises en cache par rapport à leurs données d'application avant de s'y fier pour des décisions factuelles ou à enjeux élevés.
Quels environnements et clients prend-il en charge ?
Le modèle de distribution est un binaire Go unique, ce qui simplifie le déploiement sur des systèmes capables d'exécuter des programmes Go. L'outil implémente un protocole Redis drop-in afin que les clients et bases de code Redis existants puissent interagir sans modification significative. Pour les flux de travail des agents, il s'intègre avec n'importe quel client ou plateforme d'IA qui prend en charge le protocole de contexte de modèle, avec des exemples nommés incluant Claude Desktop et Cursor, permettant un accès direct aux données depuis les agents.
Est-il facile à adopter dans les stacks existants ?
L'adoption se concentre sur l'ergonomie des développeurs et la préparation open-source. La licence BSD-3-Clause et un projet hébergé sur GitHub rendent la réutilisation du code simple, et le parcours du développeur dans les systèmes backend, Node.js, TypeScript et Go suggère un accent sur la discipline API et de déploiement. Comme l'outil cible les ingénieurs et les constructeurs d'agents IA, attendez-vous à un flux de travail orienté développement qui privilégie l'intégration de dépôt, la configuration au niveau du code et les tests itératifs plutôt que l'administration graphique.
Qui devrait considérer cet outil
L'outil est un choix pragmatique pour les équipes d'ingénierie construisant des services soutenus par des agents qui ont besoin de récupération locale et de contrôle des développeurs. Son orientation open-source soutient l'intégration basée sur des dépôts, mais les équipes devraient valider les sorties du cache sémantique par rapport à leurs ensembles de données et confirmer que leurs agents peuvent accéder au magasin via le protocole de contexte requis avant de déployer à grande échelle. Traitez-le comme un composant d'ingénierie, pas comme un produit prêt à l'emploi pour l'utilisateur final.